


정책 경사법
정책 경사법(Policy gradient methods)은 강화 학습 알고리즘의 한 종류이자 정책 최적화 방법의 하위 분류이다. 정책을 도출하기 위해 가치 함수를 학습하는 가치 기반 방법과 달리, 정책 최적화 방법은 가치 함수를 참조하지 않고 행동을 선택하는 정책 함수 를 직접 학습한다. 정책 경사를 적용하려면 정책 함수 가 미분 가능한 매개변수 에 의해 매개변수화되어야 한다.[1]


개요
[편집]정책 기반 강화 학습에서 에이전트(actor)는 매개변수화된 정책 함수 이며, 여기서 는 에이전트의 매개변수이다. 에이전트는 환경의 상태 를 인자로 받아 확률 분포 를 생성한다.


행동 공간이 이산적이면 이다. 행동 공간이 연속적이면 이다.


정책 최적화의 목표는 기대 에피소드 보상 를 최대화하는 를 찾는 것이다:여기서 는 할인 인자, 는 단계 에서의 보상, 는 시작 상태, 는 시간 지평(무한대일 수 있음)이다.


정책 경사는 로 정의된다. 다양한 정책 경사법은 정책 경사를 서로 다른 방식으로 확률적으로 추정한다. 모든 정책 경사법의 목표는 경사 상승법을 통해 를 반복적으로 최대화하는 것이다. 모든 정책 경사법의 핵심은 정책 경사의 확률적 추정이므로, 이들은 "몬테카를로 경사 추정"이라는 제목으로도 연구된다.[2]

REINFORCE
[편집]정책 경사
[편집]1992년 로널드 J. 윌리엄스가 도입한 REINFORCE 알고리즘은 최초의 정책 경사법이다.[3] 이는 정책 경사에 대한 항등식에 기반한다. 이는 "인과관계 트릭(causality trick)", 즉 해당 시점 이후의 보상으로만 각 행동에 가중치를 부여함으로써 개선될 수 있다.[1]


보조정리—점수 함수의 기댓값은 현재 또는 과거의 상태를 조건으로 할 때 0이다. 즉, 임의의 와 임의의 상태 에 대해 다음이 성립한다.


또한, 가 와 독립인 확률 변수라면 다음이 성립한다.


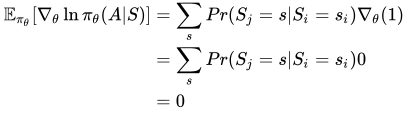


따라서 정책 경사의 불편 추정량을 얻는다:여기서 지표 은 정책 를 사용하는 개의 롤아웃 궤적에 걸쳐 있다.


점수 함수 는 상태 에서 행동 를 취할 확률을 증가시키는 매개변수 공간의 방향으로 해석될 수 있다. 즉, 정책 경사는 어떤 상태에서든 어떤 행동을 취할 확률을 증가시키는 모든 가능한 방향의 가중 평균이지만, 보상 신호에 의해 가중치가 부여된다. 따라서 특정 상태에서 특정 행동을 취하는 것이 높은 보상과 연관되어 있다면 그 방향이 크게 강화되고, 반대의 경우도 마찬가지이다.


알고리즘
[편집]REINFORCE 알고리즘은 반복문이다:
- 정책 함수로 를 사용하여 환경에서 개의 궤적을 롤아웃한다.
- 정책 경사 추정치를 계산한다:
- 경사 상승법으로 정책을 업데이트한다:


여기서 는 업데이트 단계 에서의 학습률이다.


분산 줄이기
[편집]REINFORCE는 온폴리시(on-policy) 알고리즘으로, 업데이트에 사용되는 궤적이 현재 정책 에서 샘플링되어야 함을 의미한다. 반환값 이 궤적마다 크게 다를 수 있으므로 이는 업데이트 시 높은 분산을 초래할 수 있다. REINFORCE의 많은 변형이 분산 줄이기라는 제목으로 도입되었다.

기준선을 사용한 REINFORCE
[편집]분산을 줄이는 일반적인 방법은 다음 항등식에 기반한 기준선을 사용한 REINFORCE 알고리즘이다:임의의 함수 에 대하여. 이는 이전 보조정리를 적용하여 증명할 수 있다.


이 알고리즘은 수정된 경사 추정치를 사용하며 원래의 REINFORCE 알고리즘은 인 특수한 경우이다.


액터-크리틱 방법
[편집]
가 되도록 를 잘 선택하면 경사 추정의 분산을 크게 줄일 수 있다. 즉, 기준선은 가치 함수 에 최대한 가까워야 하며, 이상적인 다음 식에 접근해야 한다:정책 가 업데이트됨에 따라 가치 함수 도 업데이트되므로 기준선도 업데이트되어야 한다는 점에 유의하라. 한 가지 일반적인 접근 방식은 가치 함수를 추정하는 별도의 함수를 학습시키고 이를 기준선으로 사용하는 것이다. 이것이 정책 함수가 액터이고 가치 함수가 크리틱인 액터-크리틱 방법 중 하나이다.


Q 함수 또한 크리틱으로 사용할 수 있는데, 다음 식과 같이 반복 기댓값 법칙을 사용한 유사한 논증에 의하기 때문이다.


기준선으로 가치 함수를 빼면, 이점 함수(advantage function) 또한 크리틱으로 사용할 수 있음을 알 수 있다:요약하면 에 대한 많은 불편 추정량이 존재하며, 모두 다음 형식을 취한다: 여기서 는 다음 항들의 선형 합이다:

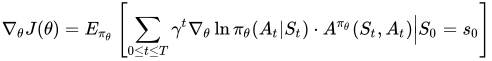


- : 사용되지 않음.
- : REINFORCE 알고리즘에서 사용.
- : 기준선을 사용한 REINFORCE 알고리즘에서 사용.
- : 1단계 TD 학습.
- .
- .

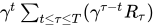


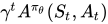
더 많은 가 가능하며, 증명은 매우 유사하다.
- : 2단계 TD 학습.
- : n단계 TD 학습.
- : GAE(일반화된 이점 추정)로 알려진 TD(λ) 학습.[4] 이는 n단계 TD 학습 항들의 지수적으로 감쇠하는 합으로 얻어진다.


자연 정책 경사
[편집]자연 정책 경사법은 2001년 샴 카카드가 제안한 정책 경사법의 변형이다.[5] 매개변수 의 선택에 의존하여 업데이트가 좌표에 종속적인 표준 정책 경사법과 달리, 자연 정책 경사는 기하학적으로 "자연스러운" 좌표 독립적 업데이트를 제공하는 것을 목표로 한다.
동기
[편집]표준 정책 경사 업데이트 는 제약된 최적화 문제를 해결한다: 목적함수(선형화된 개선)는 기하학적으로 의미가 있지만, 유클리드 제약 은 좌표 의존성을 도입한다. 이를 해결하기 위해 자연 정책 경사는 유클리드 제약을 쿨백-라이블러 발산 (KL) 제약으로 대체한다:여기서 두 정책 간의 KL 발산은 정책 하의 상태 분포에 대해 평균화된다. 즉, 이는 업데이트가 가역적인 아핀 매개변수 변환에 불변임을 보장한다.


피셔 정보 근사
[편집]작은 에 대해 KL 발산은 피셔 정보 계량으로 근사된다:여기서 는 정책의 피셔 정보 행렬로, 다음과 같이 정의된다: 이는 문제를 2차 계획법 문제로 변환하여 다음의 자연 정책 경사 업데이트를 산출한다:스텝 크기 는 일반적으로 KL 제약을 유지하도록 조정되며, 이다.


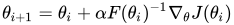


를 역행렬 취하는 것은 특히 고차원 매개변수(예: 신경망)의 경우 계산 집약적이다. 실제 구현에서는 종종 근사치를 사용한다.
신뢰 영역 정책 최적화 (TRPO)
[편집]신뢰 영역 정책 최적화 (TRPO)는 정책 업데이트에 신뢰 영역 제약을 강제함으로써 자연 정책 경사 접근 방식을 확장하는 정책 경사법이다.[6] 2015년 슐먼 등이 개발한 TRPO는 자연 정책 경사법을 개선한다.
자연 경사 하강법은 목적함수가 진정한 2차 함수라면 이론적으로 최적이지만, 이는 근사일 뿐이다. TRPO의 라인 서치와 KL 제약은 이 근사가 깨지지 않는 "신뢰 영역" 안으로 해를 제한하려고 시도한다. 이는 TRPO를 실제로 더 견고하게 만든다.
공식화
[편집]자연 정책 경사와 마찬가지로 TRPO는 좌표 독립적으로 명시된 제약 최적화 문제를 해결하여 정책 매개변수 를 반복적으로 업데이트한다:여기서

- 는 대리 이점(surrogate advantage)으로, 이전 정책 대비 의 성능을 측정한다.
- 은 신뢰 영역 반경이다.

일반적으로 다른 대리 이점도 가능하다는 점에 유의하라:여기서 는 앞서 언급한 유형의 임의의 선형 합이다. 실제로 오픈AI는 단순 이점 대신 일반화된 이점 추정을 사용할 것을 권장했다.


대리 이점 는 정책 경사 와 일치하도록 설계되었다. 특히 일 때, 는 이점 함수에서 도출된 정책 경사와 같다: 그러나 일 때는 반드시 참은 아니다. 따라서 이는 실제 목적함수의 "대리"이다.


자연 정책 경사와 마찬가지로 작은 정책 업데이트에 대해 TRPO는 주변의 테일러 급수 전개를 사용하여 대리 이점과 KL 발산을 근사한다: 여기서:


- 는 정책 경사이다.
- 는 피셔 정보 행렬이다.


이는 문제를 2차 최적화로 줄여 자연 정책 경사 업데이트를 산출한다: 지금까지는 기본적으로 자연 경사법과 동일하다. 그러나 TRPO는 두 가지 수정 사항을 통해 이를 개선한다:

- 명시적인 행렬 역행렬 없이 에서 를 반복적으로 풀기 위해 켤레기울기법을 사용한다.
- 신뢰 영역 제약이 만족되도록 백트래킹 라인 서치를 사용한다. 구체적으로, KL 제약과 정책 개선을 보장하기 위해 스텝 크기를 백트래킹한다. 즉, 다음 테스트 해를 각각 테스트한다: KL 제약 을 만족하고 더 높은 를 산출하는 해를 찾을 때까지이다. 여기서 은 백트래킹 계수이다.


근위 정책 최적화 (PPO)
[편집]추가적인 개선 사항은 클리핑된 확률 비율을 사용하는 1차 근사를 통해 와 을 계산하는 것조차 피하는 근위 정책 최적화 (PPO)이다.[7]

구체적으로, KL 발산 제약 하에서 대리 이점 을 최대화하는 대신, 제약을 대리 이점에 직접 삽입한다: 그리고 PPO는 평소와 같이 확률적 경사 하강법으로 대리 이점을 최대화한다.
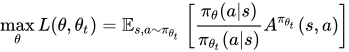
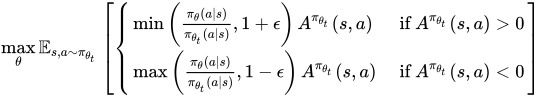
말로 하자면, 새로운 대리 이점 함수를 경사 상승시키는 것은, 어떤 상태 에서 이점이 양수()라면, 경사가 를 상태 에서 행동 를 수행할 확률을 높이는 방향으로 향하게 해야 함을 의미한다. 그러나 가 너무 많이 변하여 가 되는 즉시 경사는 그 방향을 가리키는 것을 멈춰야 한다. 인 경우도 마찬가지이다. 따라서 PPO는 매개변수 업데이트를 너무 강하게 밀어붙이는 것을 피하고 정책을 너무 많이 바꾸는 것을 피한다.


더 정확히 말하면, 를 로 업데이트하려면 동일한 데이터 배치에 대해 여러 번의 업데이트 단계가 필요하다. 로 초기화한 다음 대리 이점이 안정될 때까지 반복적으로 경사 하강법(예: Adam 옵티마이저)을 적용하여 를 업데이트한다. 그런 다음 를 에 할당하고 다시 수행한다.

이 내부 루프 동안 에 대한 첫 번째 업데이트는 경계에 도달하지 않지만, 가 에서 멀어질수록 결국 경계에 도달하기 시작한다. 이러한 각 경계 도달에 대해 해당 경사는 0이 되고, 따라서 PPO는 를 에서 너무 멀리 업데이트하는 것을 피한다.

이는 대리 손실이 상태-행동 쌍 가 에이전트가 정책 를 실행할 때 볼 수 있는 것에서 샘플링된다고 가정하지만, 정책 경사는 온폴리시여야 하기 때문에 중요하다. 그래서 가 변함에 따라 대리 손실은 점점 더 오프폴리시(off-policy)가 된다. 이것이 를 와 근접하게 유지하는 것이 필요한 이유이다.
학습된 정책이 너무 멀리 벗어나지 않아야 하는 참조 정책 가 있는 경우, 추가적인 KL 발산 페널티를 추가할 수 있다:여기서 는 페널티의 강도를 조정한다. 이는 인간 피드백을 통한 강화 학습을 사용하여 추론 언어 모델을 학습할 때 사용되었다.[8] KL 발산 페널티 항은 동등한 형식을 사용하여 더 낮은 분산으로 추정할 수 있다(자세한 내용은 f-발산 참조):[9]


그룹 상대 정책 최적화 (GRPO)
[편집]그룹 상대 정책 최적화(GRPO)는 가치 함수 추정기 를 생략하는 PPO의 사소한 변형이다. 대신 각 상태 에 대해 정책 에서 여러 행동 를 샘플링한 다음, 그룹 상대 이점을 계산한다.[9] 여기서 는 의 평균과 표준 점수이다.


그런 다음 모든 행동에 대해 평균화된 PPO 목적함수를 최대화한다:직관적으로 GRPO의 각 정책 업데이트 단계는 정책이 그 상태에서 시도된 다른 행동들보다 상대적으로 더 나은 성능을 보인 행동으로 각 상태에 대응할 가능성을 높이고, 상대적으로 더 나쁜 성능을 보인 행동으로 대응할 가능성을 낮추도록 만든다.
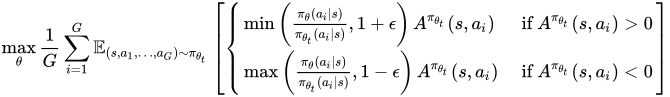
이전과 마찬가지로 학습된 정책이 참조 정책에 가깝게 유지되도록 장려하기 위해 KL 페널티 항을 적용할 수 있다. GRPO는 딥시크의 연구자들이 추론 언어 모델을 학습하는 맥락에서 처음 제안했다.[9]
정책 최적화와 미러 디센트 관점 (MDPO)
[편집]TRPO, PPO, 자연 정책 경사와 같은 방법들은 공통된 아이디어를 공유한다. 정책은 정책 경사 방향으로 업데이트되어야 하지만, 업데이트는 일반적으로 업데이트 전 정책과의 거리로 측정되는 안전하고 안정적인 방식으로 이루어져야 한다.
이러한 업데이트 안정성 개념은 미러 디센트와 같은 근위 볼록 최적화 기법에서도 발견된다.[10] 거기서 특정 제약 집합 내의 의 제안된 최소화기 는, 현재 와의 근접성 페널티를 브레그만 발산 으로 측정하여 경사 방향으로 반복적으로 업데이트되며, 다음 공식으로 공식화할 수 있다: 여기서 는 경사 하강법의 학습률과 유사하게 연속적인 반복 간의 근접성을 제어한다.


이는 정책 업데이트 절차를 기반 마르코프 결정 과정(MDP)의 (비볼록) 최적화 환경에서 최적의 정책을 찾기 위한 최적화 절차로 재고하게 한다. 정책 경사를 사용하는 이러한 최적화 관점을 미러 디센트 정책 최적화(MDPO)라고 하며,[11][12] KL이 선택된 브레그만 발산일 때 다음과 같은 업데이트로 이어진다:매개변수화된 정책 를 사용하면 MDPO 손실은 다음과 같아진다:이 목적함수는 PPO에서 수행된 클리핑과 같은 다른 일반적인 기법들과 함께 사용될 수 있다. 사실 KL 발산 페널티는 원래 PPO 논문[7]에도 나타나며, 이는 MDPO 관점이 많은 동시 정책 경사 기법 이면의 주요 유도 개념들에 대한 이론적 통합임을 시사한다.


같이 보기
[편집]각주
[편집]- 1 2 Sutton, Richard S; McAllester, David; Singh, Satinder; Mansour, Yishay (1999). “Policy Gradient Methods for Reinforcement Learning with Function Approximation”. 《Advances in Neural Information Processing Systems》 (MIT Press) 12.
- ↑ Mohamed, Shakir; Rosca, Mihaela; Figurnov, Michael; Mnih, Andriy (2020). “Monte Carlo Gradient Estimation in Machine Learning”. 《Journal of Machine Learning Research》 21 (132): 1–62. arXiv:1906.10652. ISSN 1533-7928.
- ↑ Williams, Ronald J. (May 1992). “Simple statistical gradient-following algorithms for connectionist reinforcement learning” (영어). 《Machine Learning》 8 (3–4): 229–256. doi:10.1007/BF00992696. ISSN 0885-6125.
- ↑ Schulman, John; Moritz, Philipp; Levine, Sergey; Jordan, Michael; Abbeel, Pieter (2018년 10월 20일). “High-Dimensional Continuous Control Using Generalized Advantage Estimation”. arXiv:1506.02438 [cs.LG].
- ↑ Kakade, Sham M (2001). “A Natural Policy Gradient”. 《Advances in Neural Information Processing Systems》 (MIT Press) 14.
- ↑ Schulman, John; Levine, Sergey; Moritz, Philipp; Jordan, Michael; Abbeel, Pieter (2015년 7월 6일). “Trust region policy optimization”. 《Proceedings of the 32nd International Conference on International Conference on Machine Learning》 (Lille, France: JMLR.org) 37: 1889–1897.
- 1 2 Schulman, John; Wolski, Filip; Dhariwal, Prafulla; Radford, Alec; Klimov, Oleg (2017년 8월 28일). “Proximal Policy Optimization Algorithms”. arXiv:1707.06347 [cs.LG].
- ↑ Nisan Stiennon; Long Ouyang; Jeffrey Wu; Daniel Ziegler; Ryan Lowe; Chelsea Voss; Alec Radford; Dario Amodei; Paul F. Christiano (2020). “Learning to summarize with human feedback” (영어). 《Advances in Neural Information Processing Systems》 33.
- 1 2 3 Shao, Zhihong; Wang, Peiyi; Zhu, Qihao; Xu, Runxin; Song, Junxiao; Bi, Xiao; Zhang, Haowei; Zhang, Mingchuan; Li, Y. K. (2024년 4월 27일). “DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models”. arXiv:2402.03300 [cs.CL].
- ↑ Arkadi Nemirovsky and David Yudin. Problem Complexity and Method Efficiency in Optimization. John Wiley & Sons, 1983.
- ↑ Shani, Lior; Efroni, Yonathan; Mannor, Shie (2020년 4월 3일). “Adaptive Trust Region Policy Optimization: Global Convergence and Faster Rates for Regularized MDPS”. 《Proceedings of the AAAI Conference on Artificial Intelligence》 34 (4): 5668–5675. arXiv:1909.02769. doi:10.1609/aaai.v34i04.6021. ISSN 2374-3468.
- ↑ Tomar, Manan; Shani, Lior; Efroni, Yonathan; Ghavamzadeh, Mohammad (2020년 5월 20일). “Mirror Descent Policy Optimization” (영어). arXiv:2005.09814v5 [cs.LG].
- Sutton, Richard S.; Barto, Andrew G. (2018). 《Reinforcement learning: an introduction》 2판. Adaptive computation and machine learning series. Cambridge, Massachusetts: The MIT Press. ISBN 978-0-262-03924-6.
- Bertsekas, Dimitri P. (2019). 《Reinforcement learning and optimal control》 2판. Belmont, Massachusetts: Athena Scientific. ISBN 978-1-886529-39-7.
- Grossi, Csaba (2010). 《Algorithms for Reinforcement Learning》 1판. Synthesis Lectures on Artificial Intelligence and Machine Learning. Cham: Springer International Publishing. ISBN 978-3-031-00423-0.
- Mohamed, Shakir; Rosca, Mihaela; Figurnov, Michael; Mnih, Andriy (2020). “Monte Carlo Gradient Estimation in Machine Learning”. 《Journal of Machine Learning Research》 21 (132): 1–62. arXiv:1906.10652. ISSN 1533-7928.
외부 링크
[편집]- Weng, Lilian (2018년 4월 8일). “Policy Gradient Algorithms” (영어). 《lilianweng.github.io》. 2025년 1월 25일에 확인함.
- “Vanilla Policy Gradient — Spinning Up documentation”. 《spinningup.openai.com》. 2025년 1월 25일에 확인함.
인공지능 (AI) | |||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 개념 | |||||||||||||
| 응용 | |||||||||||||
| 구현체 |
| ||||||||||||
| 인물 |
| ||||||||||||
| 신경망 아키텍처 | |||||||||||||
| 정치적 이슈 | |||||||||||||
| 사회 및 경제 | |||||||||||||
