


Per eseguire in modo efficiente i carichi di lavoro di intelligenza artificiale (AI) o machine learning (ML), devi selezionare sia un orchestratore di workload sia una piattaforma di deployment. Questi componenti funzionano nel seguente modo:
Un orchestratore pianifica ed esegue i job.
Un'opzione di deployment gestisce un orchestratore.
Dopo aver identificato l'infrastruttura GPU (GPU in cluster o GPU generiche) da utilizzare per eseguire i carichi di lavoro, segui le indicazioni riportate in questo documento per identificare l'orchestratore e il deployment più adatti al tuo carico di lavoro e al tuo livello di gestione.
Per esaminare i tipi di macchine GPU che puoi utilizzare per eseguire i tuoi carichi di lavoro, consulta la sezione Macchine GPU.
Confrontare gli orchestratori e le opzioni di deployment
AI Hypercomputer offre diversi orchestratori e opzioni di deployment per le tue istanze di calcolo. Queste opzioni vanno dai cluster completamente gestiti che ti consentono di concentrarti sui carichi di lavoro agli ambienti autogestiti che offrono un controllo granulare su come gestire e aggiornare le istanze di computing.
La seguente tabella confronta gli orchestratori e le opzioni di deployment che puoi utilizzare quando esegui carichi di lavoro di AI:
| Prodotto | Orchestratore | Complessità tecnica | Consigliato per | Vantaggio principale |
|---|---|---|---|---|
| Cluster Director | Slurm | Bassa | Ricercatori di AI, data scientist | Ciclo di vita gestito per i cluster Slurm |
| Google Kubernetes Engine (GKE) | Kubernetes | Da medio ad alto | ML engineer, Platform engineer | Orchestrazione e scalabilità dei container |
| Cluster Toolkit | Slurm, Kubernetes | Media | ML DevOps, ingegneri di piattaforma | Progetti base di Infrastructure as Code convalidati |
| Compute Engine | Personalizzato / Nessuno | Alta | Architetti dell'infrastruttura | Controllo granulare del sistema operativo e del networking |
Scegli un orchestratore e un'opzione di deployment
Per scegliere un orchestratore e un'opzione di deployment, utilizza il seguente diagramma di flusso:
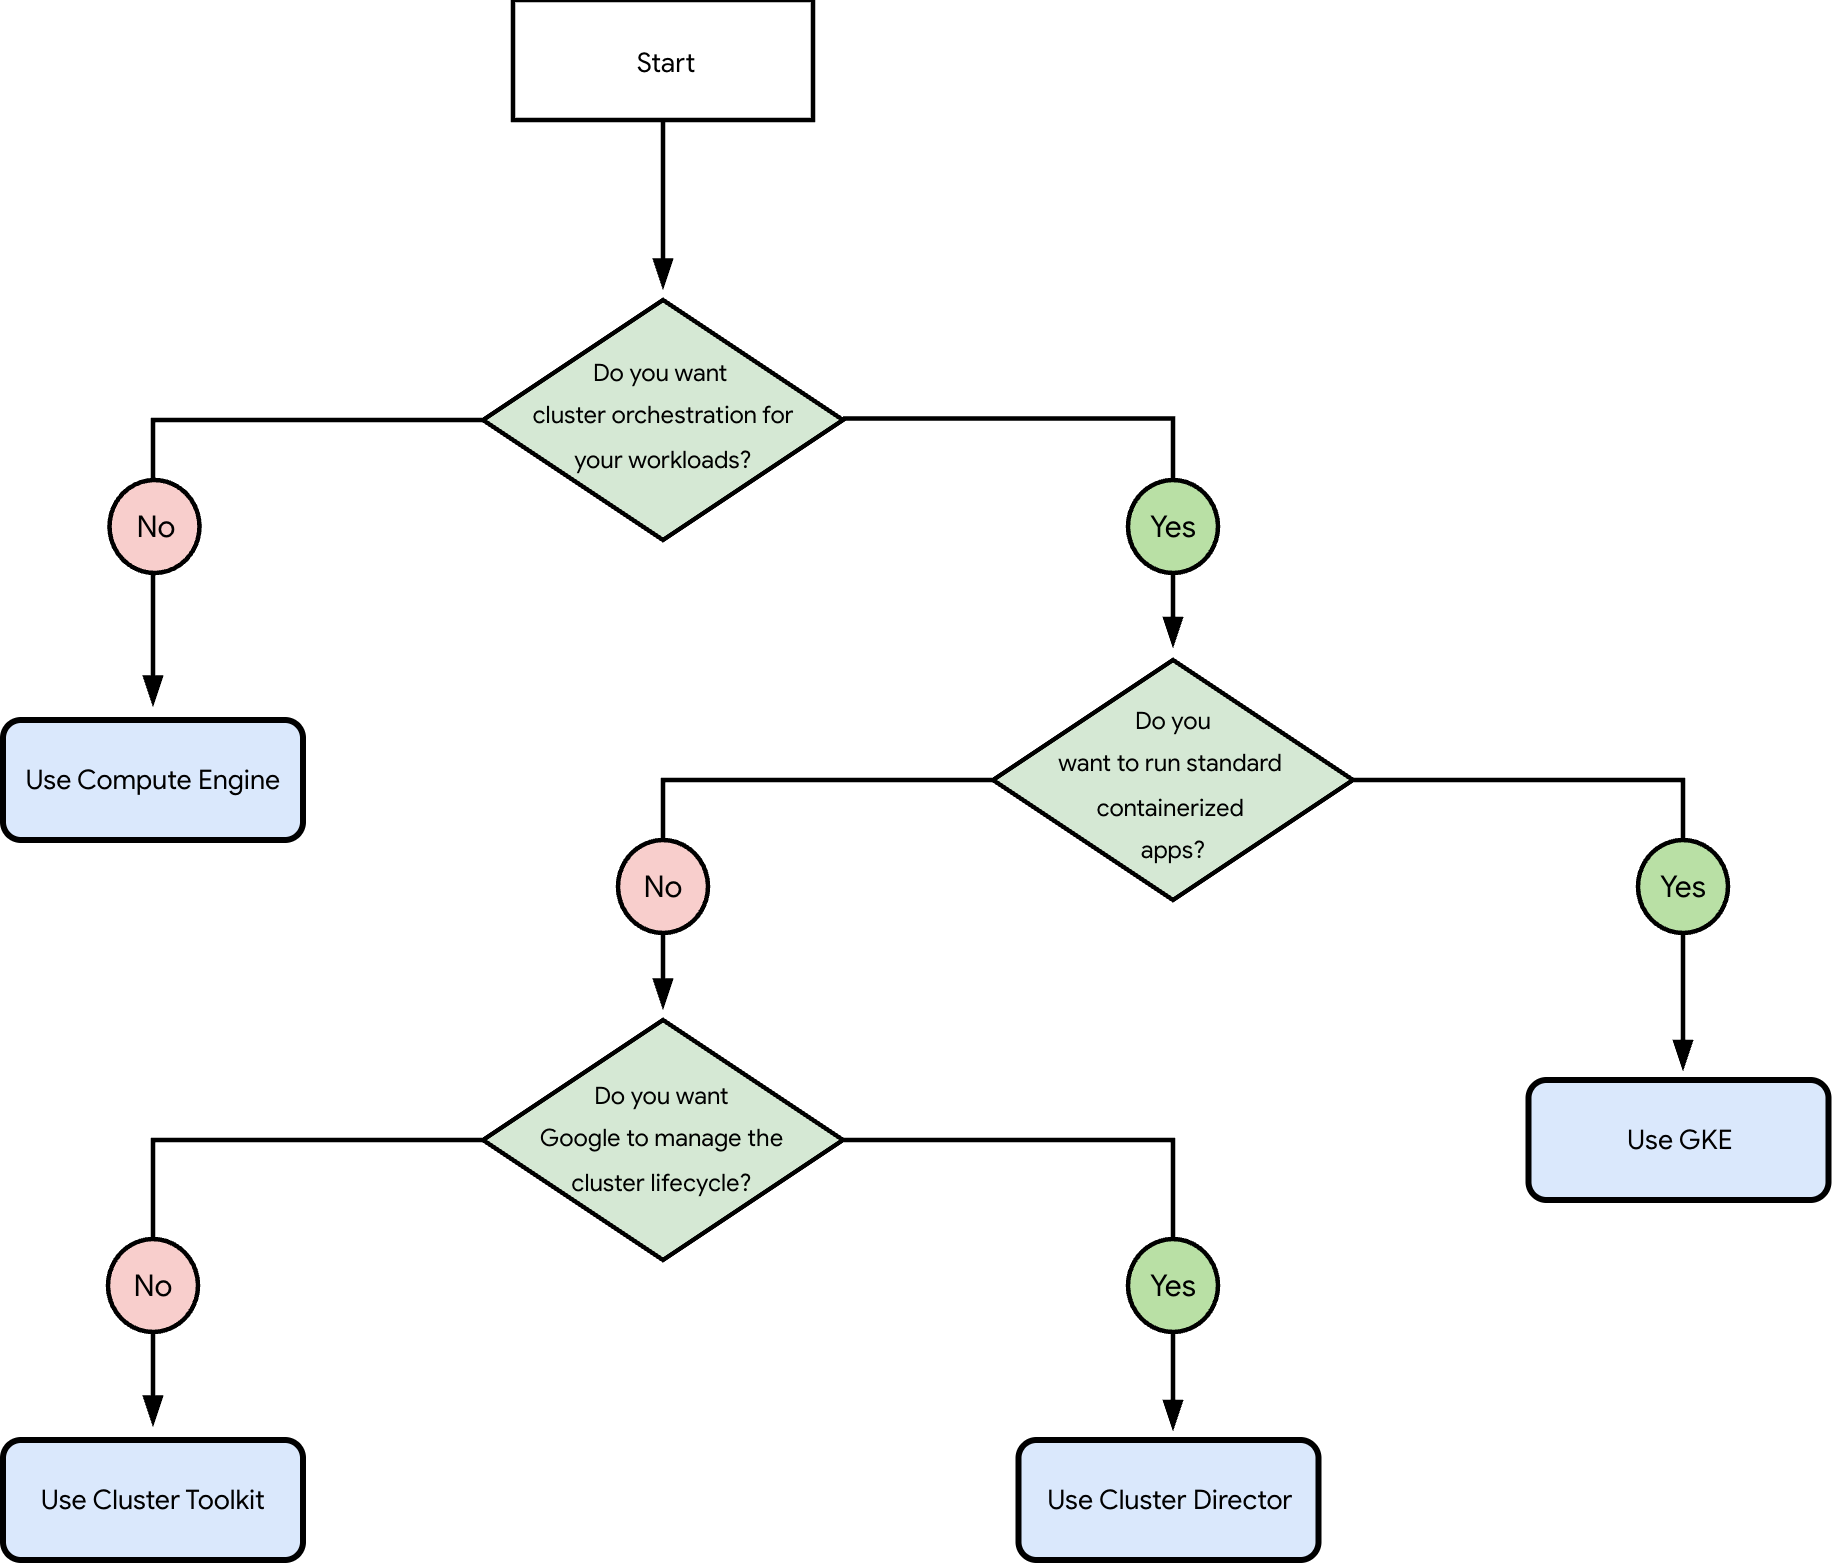
Il diagramma di flusso precedente pone le seguenti domande:
Vuoi l'orchestrazione dei cluster per i tuoi carichi di lavoro?
- Sì: vai alla domanda 2.
- No: utilizza Compute Engine.
Vuoi eseguire app containerizzate standard?
- Sì: utilizza GKE.
- No: vai alla domanda 3.
Vuoi che Google gestisca il ciclo di vita del cluster?
- Sì: utilizza Cluster Director.
- No: utilizza Cluster Toolkit.
Orchestratori supportati
Un orchestratore automatizza la gestione dei cluster ed elimina la necessità di gestire ogni istanza di computing individualmente. Gli orchestratori come Slurm o Kubernetes gestiscono la gestione delle code dei job, l'allocazione delle risorse e lo scalabilità automatica.
Slurm: un orchestratore open source di uso comune per i workload AI, ML e HPC. Puoi utilizzare Slurm con Cluster Toolkit o Cluster Director.
Kubernetes: una piattaforma di orchestrazione di container open source. Puoi eseguire il deployment di Kubernetes utilizzando GKE direttamente o tramite Cluster Toolkit.
Personalizzato o nessuno: utilizza Compute Engine se preferisci un altro orchestratore o vuoi gestire le tue istanze di calcolo senza un orchestratore. Questa opzione offre il massimo livello di controllo, ma richiede di configurare, gestire e aggiornare manualmente le istanze di calcolo.
Piattaforme di deployment supportate
Dopo aver identificato l'orchestratore e l'opzione di deployment consigliati per il tuo caso d'uso, esamina le relative descrizioni riportate di seguito per verificare che i livelli di gestione e le funzionalità soddisfino i requisiti del carico di lavoro.
Piattaforme gestite e automatizzate
Se vuoi evitare l'overhead della gestione di un cluster e concentrarti invece sull'esecuzione dei carichi di lavoro, utilizza una delle seguenti piattaforme gestite:
Cluster Director: un servizio completamente gestito che automatizza il ciclo di vita dei cluster Slurm. Utilizza Cluster Director per semplificare la configurazione dei cluster Slurm. Cluster Director automatizza il ciclo di vita dei cluster in modo che tu possa concentrarti sull'esecuzione dei tuoi workload AI, ML o HPC. Per saperne di più, consulta la panoramica di Cluster Director.
GKE: un ambiente Kubernetes gestito ottimizzato per i workload di AI e ML. Utilizza GKE per orchestrare i workload containerizzati, integrarti con hardware Compute Engine specializzato e sfruttare funzionalità specifiche di GKE come Topology Aware Scheduling (TAS). Per maggiori informazioni, consulta Panoramica di GKE.
Piattaforme semi-gestite e autogestite
Se hai bisogno di un controllo granulare sul sistema operativo, sulle configurazioni del kernel o sulle versioni dei driver, utilizza una piattaforma semi-gestita o autogestita:
Cluster Toolkit: un toolkit open source che fornisce progetti iniziali convalidati e personalizzabili per il deployment di ambienti AI e ML riproducibili. Offre elevata flessibilità e controllo utilizzando i principi di Infrastructure as Code (IaC). Per saperne di più, consulta la panoramica di Cluster Toolkit.
Compute Engine: un servizio di computing personalizzabile che offre il massimo controllo per la creazione di ambienti personalizzati da zero. Sebbene non sia un orchestratore autonomo, Compute Engine funge da base per gli utenti che preferiscono creare e gestire i propri stack personalizzati specializzati. Per saperne di più, consulta la panoramica di Compute Engine.
Passaggi successivi
- Per ottenere la capacità, consulta Opzioni di consumo.
- Per eseguire il deployment del cluster, consulta la panoramica della creazione del cluster.